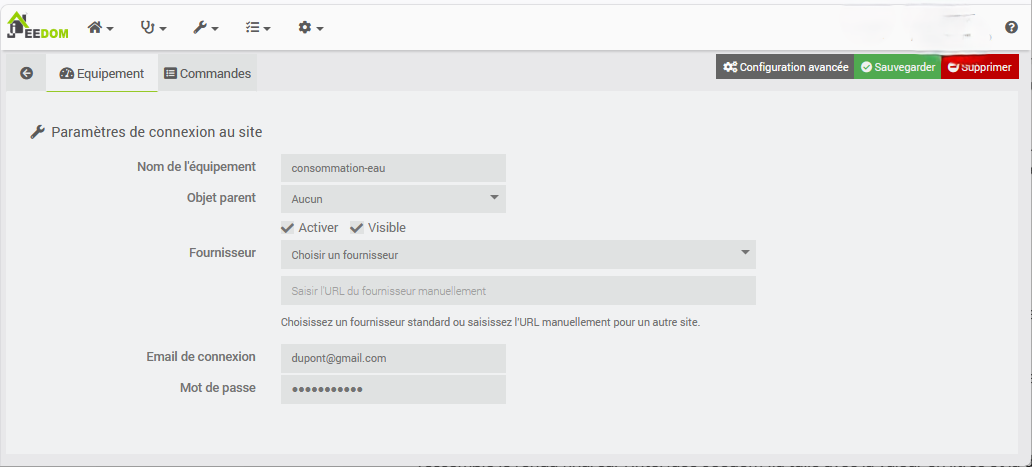
Je vous présente aujourd’hui mon nouveau plugin Abaqua, disponible en Bêta. Il est conçu pour intégrer automatiquement et de manière fiable le suivi de votre consommation d’eau dans Jeedom.
Ce plugin nécessite de disposer d’un compteur d’eau communicant compatible avec la plateforme du fournisseur.
Il a été testé avec le site Kyrnolia (Veolia Corse). Il devrait également fonctionner sur le site Veolia ainsi que sur certaines de ses succursales, selon la structure de la plateforme et les éventuels changements de code.
Edit: un utilisateur a testé sur Veolia Rhone, fonctionnement ok.
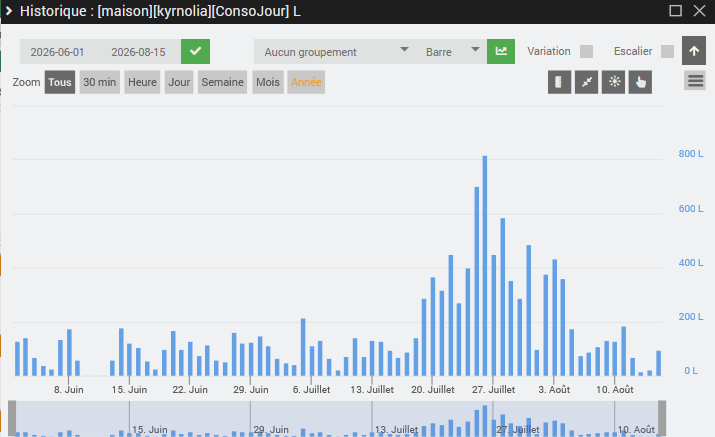
Le plugin se connecte à votre espace client, lit les consommations journalières (en litres) et les enregistre dans l’historique Jeedom avec une séparation claire entre :
La date de valeur : le jour exact de consommation
La date de collecte : la date où le plugin a vérifié le site
Il est conçu pour rester robuste face aux changements de page ou de structure du site.
Fonctionnalités & Débogage
Création automatique des commandes Jeedom (Consommation jour, Rafraîchir, Log).
Prise en charge d’un widget de log dédié.
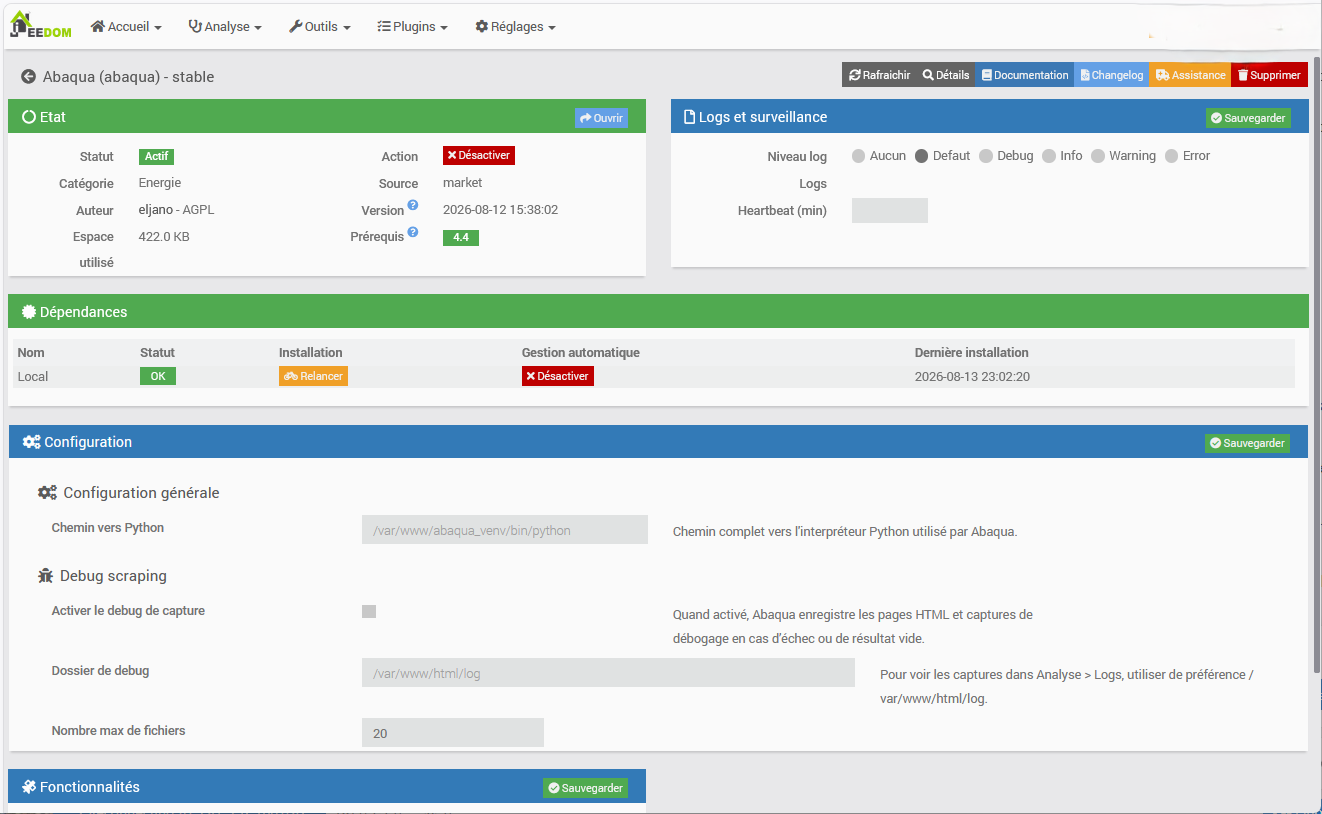
Débogage avancé : En cas d’échec de scraping, sauvegarde des pages HTML d’erreur, d’un JSON de contexte et du chemin exact dans les logs sans stocker les mots de passe en clair.
/www est vraiment un emplacement de m… pour aller créer un venv… et que c’est pas le genre de paramètres à laisser à l’utilisateur;
exemple: il se passe quoi lors de la désinstallation du plugin? Et lors d’un backup, on va inclure tout le venv avec? Des centaines de mégas potentiellement?
que vous n’êtes pas autorisé à écrire quoi que ce soit dans le dossier log (excepté un fichier de log dont le nom commence par l’id du plugin), pas de json ni html
c’est un dossier du core donc certainement pas à y gérer les fichiers (nombres max de fichiers???)
Relisez la doc dev pour connaître la structure d’un plugin…
Seul le sous-répertoire html est sauvegardé dans le backup. Curieux que vous ne la sachiez pas.
C’est justement pour cette raison que le venv est placé à cet endroit, en amont de html. En ce qui concerne la desinstallation, le repertoire abaqua_venv est ausi desinstallé.
Concernant les fichiers de debug, ils ne sont créés que dans le cas de problèmes, merci de m’avoir indiqué cette “faute”, dites moi où je pourrais les placer ?
Et pour votre information, aujourd’hui en retraite, je suis ingénieur electronicien (Polytech-Lille EUDIL) sorti en 1978, j’ai travaillé 10 ans dans la conception de cartes électroniques à la CGCT (téléphone public), puis j’ai bifurqué dans le soft pendant 30 ans. Et bien sur que je me suis fais aider par l’IA, les développeurs qui aujourd’hui ne le font pas peuvent aller pointer au chomage.
Bah, je nie en rienles compétences de qui que ce soit, mais ouvrez un fichier de backup, très simple, vous le rapatriez et vous l’ouvrez, vous verrez que la racine du backup est bien html, pas www.
Pour le venv, je recommande le dossier ressources du plugin. Et en fait tout fichiers généré par le plugin devrait se trouver dans un sous-dossier du plugin car autre avantage, en cas de désinstallation tout par avec.
Si le dossier est nommé « venv » ou « python_venv » de mémoire alors par convention il ne sera pas dans le backup.
Si autre nom il doit être ajouté manuellement (par le plugin) dans les exclusions (il y a une méthode pour ça).
Les autres données générées par le plugin devraient se trouver dans le dossier data (du plugin)
De nouveau, prévoir les exclusions de backups qui vont bien.
Il y a 2 méthodes recommandées pour y arriver et dans les 2 cas, le dev n’a pas besoin de se préoccuper de ce dossier car c’est géré en standard
c’est le problème de l’IA, elle réinvente la roue; c’est bien pour ca qu’il faut revoir ce qu’elle fait en sachant où on veut aller.
Pour information, il existe déjà un plugin permettant de récupérer les informations depuis un compte Veolia, qu’il s’agisse de l’ancienne ou de la nouvelle génération.
Ce plugin, Veolia Pro, fonctionne très bien et ne nécessite aucune dépendance particulière
Une analyse des échanges réseau m’a permis d’identifier précisément les requêtes nécessaires pour récupérer les informations, sans avoir à gérer toute la partie HTML / JavaScript / CSS. Cela simplifie considérablement le code et rend le fonctionnement beaucoup plus stable : il est moins probable que le backend soit modifié fréquemment, contrairement au frontend.
Au final, le plugin est donc beaucoup plus léger, plus simple à maintenir, et il n’est pas nécessaire de mettre en place un environnement virtuel Python avec Playwright / Chromium.
Je publie une nouvelle version beta du plugin Abaqua : 2.2.2.
Cette beta corrige un point important sur les mises à jour : le cache Playwright et l’environnement virtuel Python peuvent rester obsolètes après une mise à niveau, ce qui provoquait des erreurs du type “Executable doesn’t exist” et empêchait le lancement du navigateur.
Dans cette version et suite aux remarques et conseils :
nettoyage des anciens caches Playwright
suppression de l’ancien environnement Python virtuel
recréation propre des dépendances du plugin
correction des chemins runtime vers le dossier local du plugin (resources/abaqua_venv et data/ms-playwright)
amélioration du gestionnaire de debug et du stockage local dans data/debug
Exclusion des dossiers de runtime du plugin de la sauvegarde Jeedom via la méthode backupExclude().
Important :
Il est impératif de desinstaller la version précédente avant l’installation de la nouvelle version 2.2.2.
Après installation de cette beta, il faut bien sur réinstaller les dépendances du plugin pour nettoyer les anciens fichiers et recréer le bon environnement.
Merci de tester cette version beta et de remonter les retours, en particulier sur :
 ,
 Informations générales
 Informations techniques
 Important
 Ce que fait le plugin
 Fonctionnalités & Débogage
 Configuration d’un équipement